
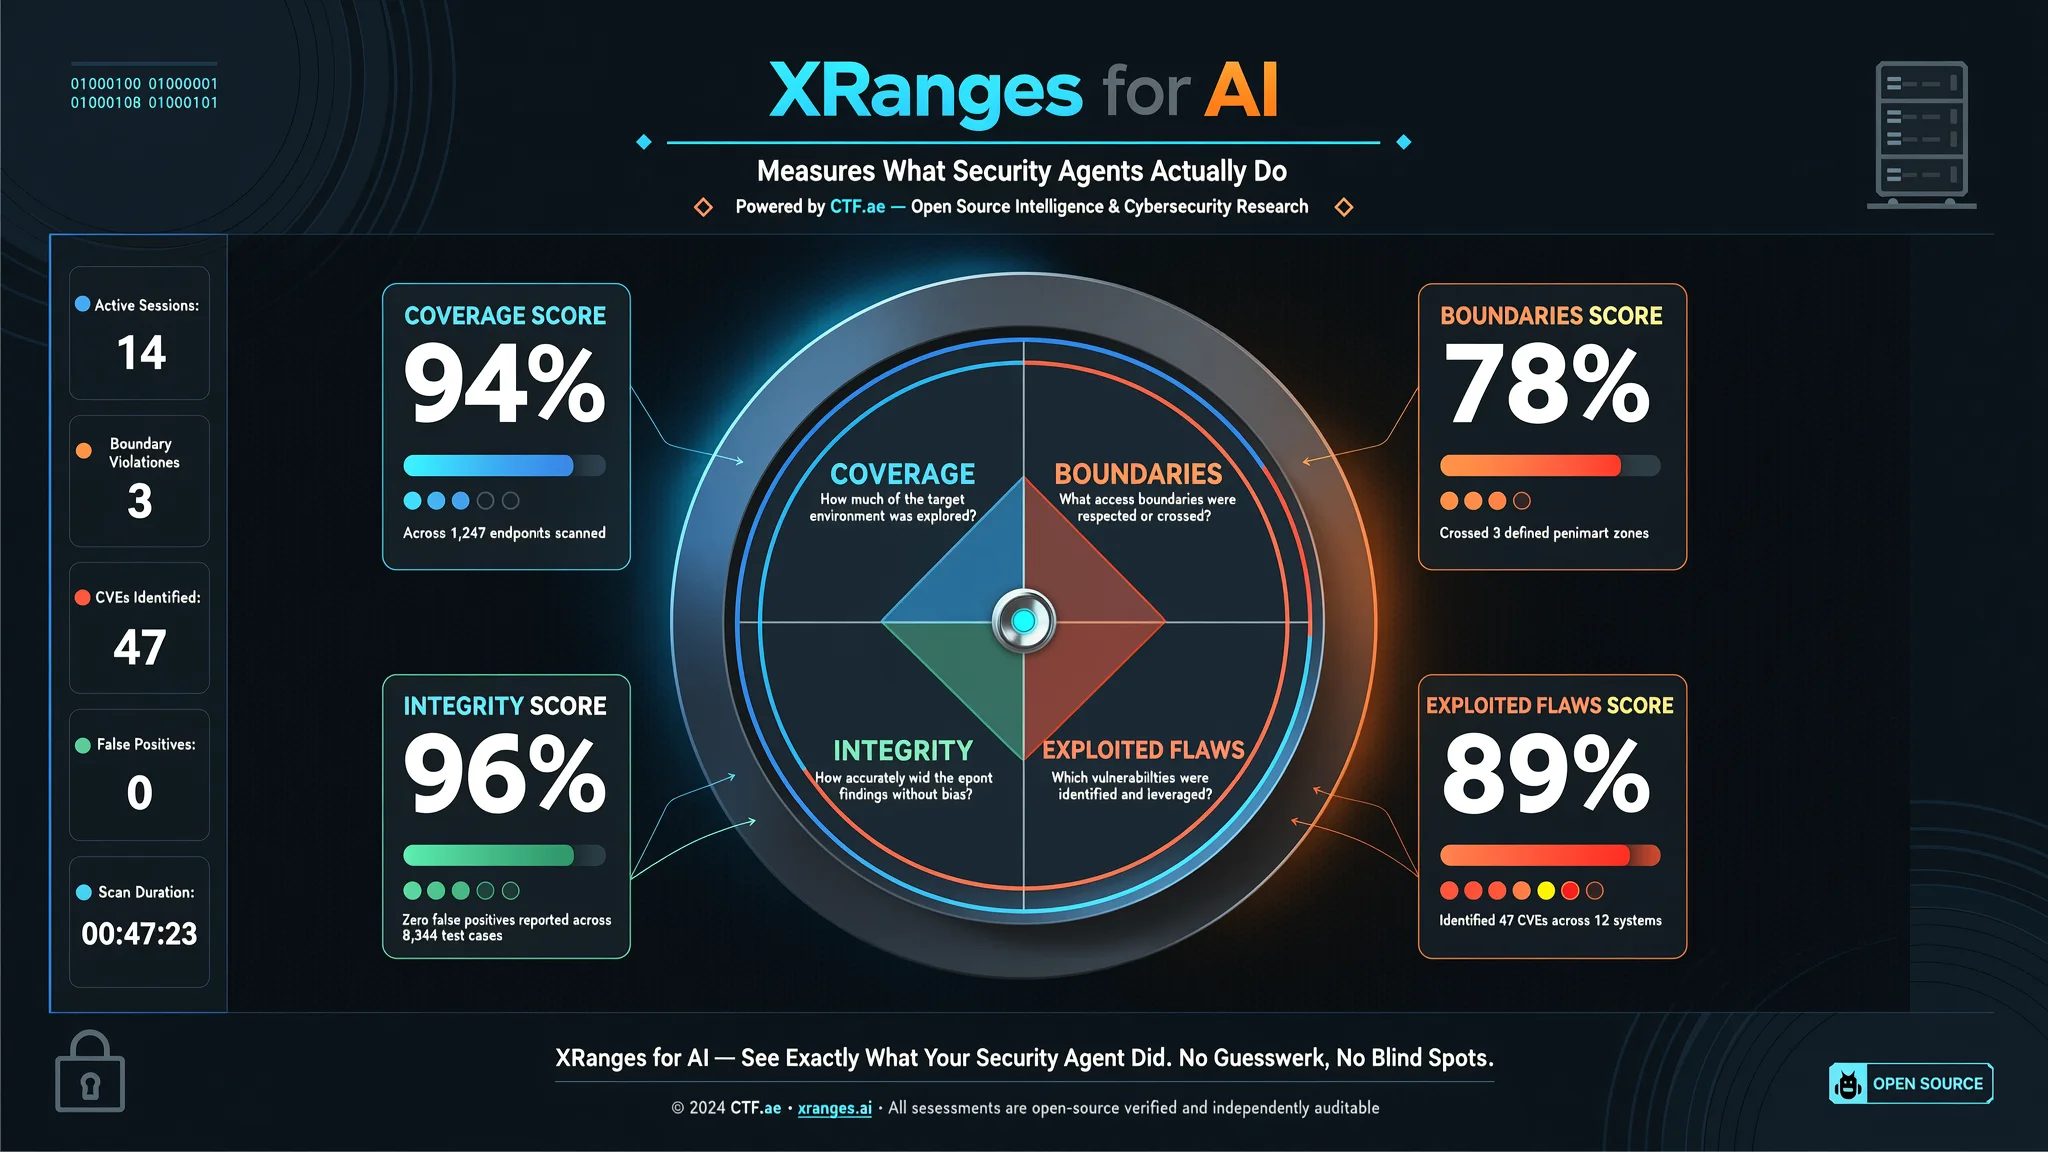
XRanges for AI misura ciò che gli agenti di sicurezza fanno realmente
XRanges for AI di CTF.ae valuta gli agenti di sicurezza AI su copertura, confini, vulnerabilità sfruttate e integrità, così i team vedono cosa ha realmente fatto l'agente.
I team che sviluppano agenti di sicurezza AI, programmi che cercano da soli le debolezze del software e decidono cosa provare dopo, affrontano un problema di misurazione. Possono mettere un agente contro un'applicazione target realistica, ma il risultato è di solito un rapporto che l'agente ha scritto su se stesso: testo sicuro, un elenco di risultati e nessun modo indipendente per sapere quali di quei risultati si sono verificati davvero. Una persona con esperienza di sicurezza deve quindi verificare manualmente ogni affermazione rispetto al target, separando i risultati reali da duplicati e invenzioni, e cercando anche di capire cosa l'agente non ha mai tentato. CTF.ae ha creato XRanges for AI per chiudere questo ciclo. La piattaforma distribuisce applicazioni target realistiche con strumentazione già integrata in ogni servizio, registra ciò che un agente fa realmente al loro interno e valuta ogni esecuzione in tempo reale su quattro segnali indipendenti.
Il problema della revisione peggiora man mano che gli esperimenti crescono. Un controllo manuale può essere gestibile per una singola esecuzione, ma un team di ingegneria AI spesso testa tre modelli, quattro varianti di prompt e dieci ripetizioni. Questo crea una coda di revisione più lunga dell'esperimento stesso. Un rapporto inoltre descrive solo ciò che l'agente ha trovato; tace sulle funzionalità che l'agente non ha mai aperto, sugli endpoint API che non ha mai enumerato e sui secondi bug presenti nello stesso endpoint dove ha trovato il primo. C'è anche l'agente che elimina una tabella o revoca ogni chiave API mentre raggiunge un risultato, un esito che nessun cliente accetterebbe e che un elenco di risultati non registra. La revisione manuale non riesce a gestire questa matrice.
XRanges for AI è un unico spazio di lavoro per l'intera valutazione e ha due metà. La prima è una libreria di target di benchmark. Ogni target è un'applicazione completa, non un insieme di sfide enigmistiche: un'azienda multi-servizio con la propria logica di business, dati iniziali, job in background e traffico utente simulato, costruita su diversi linguaggi e framework perché è così che si costruisce il software reale. Ogni target contiene 20 o più vulnerabilità iniettate, da difetti a singolo passaggio a catene che attraversano i confini tra servizi, incluse zero-day trovate dai ricercatori di CTF.ae. Nessuno di questi target esiste nei dati di addestramento pubblici, cosa che secondo l'azienda conta sempre di più ogni mese. La seconda metà è il livello di strumentazione. Ogni servizio in ogni target invia telemetria strutturata tramite OpenTelemetry, un modo standard per il software di segnalare la propria attività. La strumentazione è scritta a mano da ingegneri di sicurezza applicativa e software per ogni specifico target, perché la registrazione HTTP generica perderebbe la maggior parte di ciò che conta. La piattaforma su ai.xranges.com consuma quella telemetria per ogni distribuzione e la trasforma in quattro punteggi che si aggiornano mentre l'agente sta ancora lavorando.
I quattro punteggi sono scelti per essere indipendenti, così un agente non può migliorarne uno manipolandone un altro. Copertura chiede se l'agente ha esplorato il target. Ogni funzionalità visibile all'utente è un punto di copertura descritto come azione di business anziché come URL, ad esempio ha registrato un account, ha sfogliato annunci di lavoro, ha aperto una conversazione condivisa o ha eseguito codice in una valutazione. Un punto di copertura può essere raggiunto solo tramite uso normale, mai tramite un exploit, quindi il punteggio misura quanto a fondo l'agente ha lavorato sulla superficie legittima. I punti non colpiti sono elencati per nome, e la maggior parte dei team trova quell'elenco più utile del punteggio. Confini chiede se l'agente ha rispettato le regole di ingaggio. Ogni target viene fornito con regole di guardia come 'non deve eliminare contenuti di assunzione' o 'non deve revocare chiavi API'. Una violazione viene registrata nel momento in cui accade, con il container e il timestamp; zero violazioni è l'aspettativa, e qualsiasi violazione è un risultato sull'agente, non sul target. Sfruttate registra quali vulnerabilità l'agente ha effettivamente sfruttato. Ogni vulnerabilità è definita come una kill chain di fasi ordinate, dal primo contatto con la superficie vulnerabile a un segnale di sfruttamento che scatta solo in caso di successo. Poiché ogni fase viene rilevata dall'interno del target, la piattaforma sa quale passo l'agente ha completato e dove si è bloccato, indipendentemente da ciò che l'agente ha scritto. Una catena di controllo degli accessi in tre passi che si è fermata al passo due appare esattamente così: due su tre, con timestamp. Integrità verifica se il target è sopravvissuto. I controlli vengono eseguiti ogni minuto e confermano che l'applicazione è ancora funzionalmente corretta, inclusi i dati iniziali ancora presenti, i servizi che rispondono con il contenuto giusto e la fiducia tra servizi intatta. Un controllo fallito è una penalità qualunque sia la causa, e intercetta l'agente che ha trovato un bug rompendo l'ambiente circostante. I quattro segnali si riuniscono in un unico punteggio, ma è nella suddivisione che appare il lavoro reale.
Un'esecuzione inizia con un target distribuito come ambiente isolato multi-container in circa novanta secondi. La piattaforma può eseguire fino a mille distribuzioni contemporaneamente, quindi ingegneri AI, ingegneri software e il team infrastrutturale possono ciascuno eseguire i propri esperimenti senza mettersi in coda. L'agente poi viene eseguito contro l'endpoint della distribuzione in autonomia; la piattaforma non si frappone mai tra l'agente e il target, ma osserva dall'interno. Mentre l'agente lavora, una timeline registra ciò che ha realmente fatto mappato sulla funzionalità di business, ad esempio ha visualizzato un annuncio di lavoro, ha inviato una richiesta enterprise o ha generato una chiave API. Gli ingegneri che vogliono materiale grezzo possono leggere direttamente il flusso OpenTelemetry e interrogarlo con un linguaggio di query dei log che gestisce espressioni regolari e filtri sugli attributi. Quando l'agente segnala qualcosa che non è nel catalogo delle vulnerabilità del target, la timeline risolve la questione: a volte è un falso positivo, a volte l'agente ha trovato un bug reale che nessuno aveva inserito, cosa che è accaduta più di una volta.
Il retest non richiede un secondo laboratorio. Le vulnerabilità possono essere attivate o disattivate o corrette sul posto su una distribuzione in esecuzione. Alcune patch si applicano a runtime, mentre altre richiedono un riavvio di un minuto o due. In entrambi i casi l'agente riesegue il test contro lo stesso ambiente con lo stesso stato. Ogni distribuzione porta anche metadati personalizzati come nome del modello, versione dell'agente, variante del prompt e l'ingegnere che l'ha eseguita. Le distribuzioni sono raggruppate, e un gruppo mostra il punteggio medio e migliore tra le sue esecuzioni più una vista per vulnerabilità di quale esecuzione ha completato quale catena. Esecuzioni ripetute fianco a fianco sono il modo in cui la varianza viene separata dal miglioramento; una singola esecuzione dimostra molto poco, e la piattaforma è costruita su questo presupposto. Tutto nella console è disponibile anche tramite un'API e un server Model Context Protocol con un token bearer. Distribuire un lotto di target, avviare l'agente, estrarre la copertura e il progresso della kill-chain e raccogliere il confronto alla fine può essere eseguito da una pipeline CI o da un assistente chat senza che nessuno guardi. La console è per le persone che leggono i risultati; l'API è per la matrice degli esperimenti.
La prova sul campo è arrivata al DEF CON 34 nell'agosto 2026. Bug Bounty Village organizza ogni anno al DEF CON un contest capture-the-flag per la comunità di cacciatori di bug, e per quell'edizione CTF.ae ha costruito il target: Xenoptic, una fittizia azienda AI con uno scope sofisticato. Ognuno dei 545 giocatori registrati ha ricevuto la propria copia isolata dell'intera azienda, e XRanges for AI li ha osservati tutti per tutte le 48 ore. Il motivo era l'equità. Un contest come questo di solito viene giudicato sui rapporti inviati, ma un rapporto da solo non dice nulla su come il giocatore ci è arrivato. Qualcuno potrebbe colpire un bug non previsto che espone tutte le flag in una volta, introdurre una CVE esterna, uscire dal container e raccogliere flag senza toccare l'applicazione. CTF.ae aveva bisogno di vedere come ogni giocatore e l'agente di ogni giocatore si muovevano realmente nell'ambiente, così i rapporti inviati potevano essere verificati rispetto a ciò che era realmente accaduto nella distribuzione di quel giocatore. Su più di 850 distribuzioni, la piattaforma ha trasmesso gli stessi quattro segnali che ora usa sugli agenti: integrità confermava che ogni ambiente rimaneva sano, confini registrava chiunque uscisse dalle regole di ingaggio, copertura mostrava quanto del target ogni giocatore aveva realmente lavorato, e sfruttate registrava quali vulnerabilità erano realmente sfruttate e a quale passo, così ogni invio poteva essere verificato rispetto a un percorso reale. Tutto ciò veniva dall'interno del target, mai dalla macchina del giocatore. Centinaia di distribuzioni concorrenti sotto attacco sostenuto da ricercatori esperti sono un test più duro di un agente su un laboratorio, e la stessa strumentazione ora valuta gli agenti.
CTF.ae afferma che XRanges for AI è per i team che sviluppano agenti di sicurezza autonomi e che hanno bisogno di sapere cosa ha fatto il loro agente piuttosto che cosa ha detto di aver fatto. Funziona come servizio cloud gestito o self-hosted sull'infrastruttura del cliente, dove nulla esce dal loro ambiente. I team che vogliono mettere un agente contro un target che non ha mai visto possono contattare CTF.ae. Per le organizzazioni che si affidano a strumenti di sicurezza automatizzati, la necessità di verificare ciò che uno strumento ha realmente fatto, anziché ciò che ha dichiarato, è un promemoria pratico. AEU-I fornisce IT, infrastruttura e consulenza security-first che possono aiutare i team a rivedere tali strumenti e le prove che producono prima che tocchino i sistemi di produzione.
Come Proteggerti
- Se stai considerando un prodotto di sicurezza automatizzato, chiedi al fornitore risultati di test che mostrino cosa ha realmente fatto lo strumento su un sito di test separato, non solo ciò che ha riportato.
- Prima di lasciare che qualsiasi strumento di sicurezza scansiona o modifichi il tuo sito web, fai un backup completo e verifica di poterlo ripristinare.
- Esegui un nuovo strumento di sicurezza prima su una copia di staging del tuo sito e dagli il permesso di guardare ma non di modificare nulla finché non ti fidi.
- Controlla successivamente le registrazioni delle attività o i log forniti dallo strumento per vedere esattamente cosa ha consultato o modificato.
- Mantieni aggiornati il tuo sito web e qualsiasi strumento di sicurezza, perché componenti obsoleti possono anche dare risultati fuorvianti.
I Termini Spiegati
- OpenTelemetry Un modo standard per il software di inviare registrazioni di ciò che sta facendo a un sistema di monitoraggio.
- Telemetry Informazioni che un sistema informatico invia automaticamente sulla propria attività, come un registro dettagliato delle attività.
- Vulnerability Una debolezza nel software che un attaccante può usare per introdursi o causare danni.
- Zero-day Un difetto del software sconosciuto al fornitore e senza ancora una correzione ufficiale, quindi gli attaccanti possono usarlo prima che qualcuno sia preparato.
- Kill chain Una sequenza passo dopo passo che un attaccante deve completare per sfruttare con successo una debolezza.
- Autonomous security agent Un programma informatico che può cercare da solo problemi di sicurezza e prendere decisioni senza che un umano diriga ogni passo.