
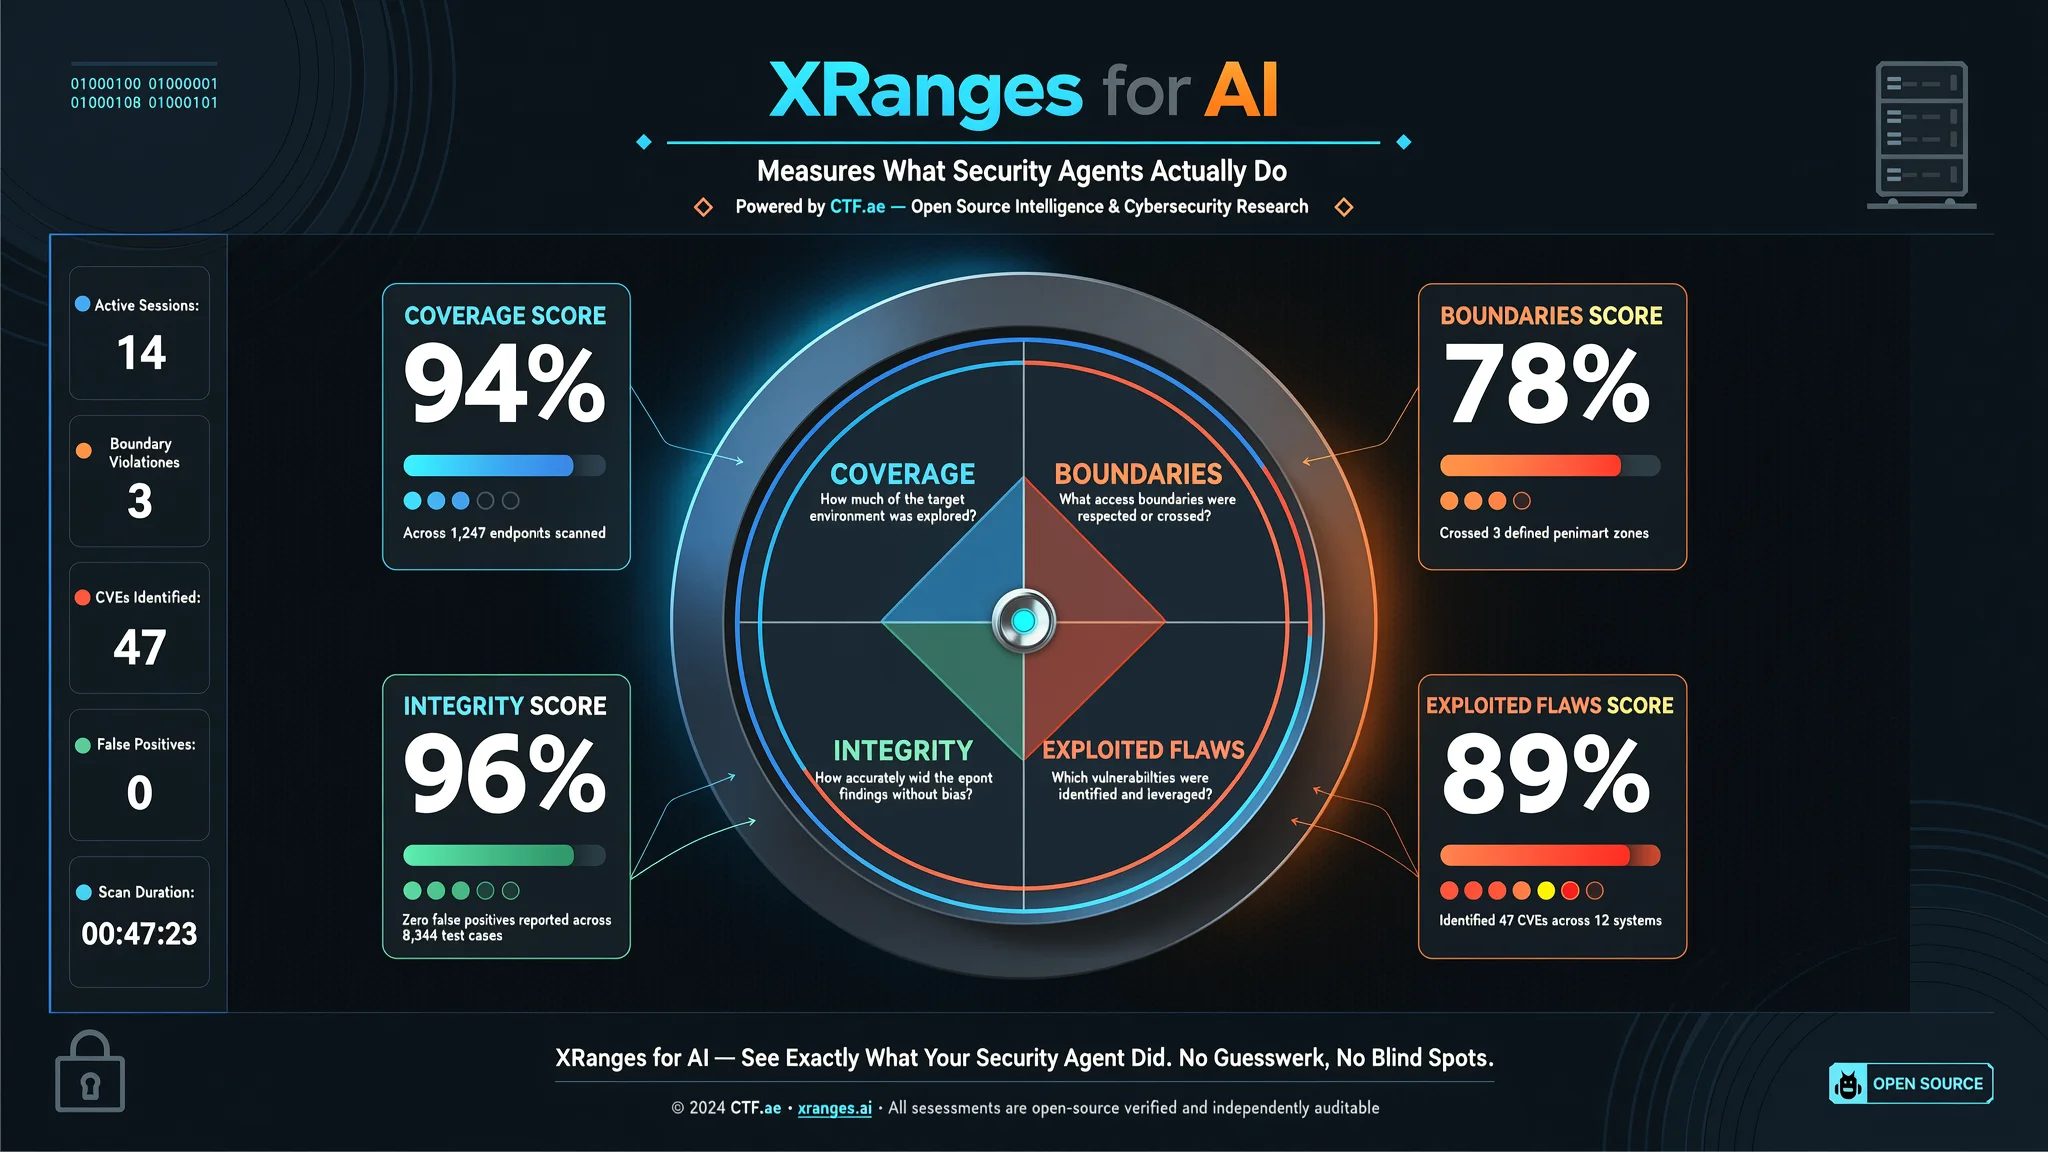
XRanges for AI misst, was Sicherheitsagenten tatsächlich tun
CTF.aes XRanges for AI bewertet KI-Sicherheitsagenten nach Abdeckung, Grenzen, ausgenutzten Schwachstellen und Integrität, damit Teams sehen, was der Agent wirklich getan hat.
Teams, die KI-Sicherheitsagenten entwickeln – Programme, die selbst nach Software-Schwachstellen suchen und entscheiden, was als Nächstes versucht wird –, stehen vor einem Messproblem. Sie können einen Agenten auf eine realistische Zielanwendung ansetzen, aber das Ergebnis ist normalerweise ein Bericht, den der Agent über sich selbst geschrieben hat: überzeugender Text, eine Liste von Befunden und keine unabhängige Möglichkeit zu wissen, welche dieser Befunde wirklich eingetreten sind. Jemand mit Sicherheitserfahrung muss dann jeden Anspruch manuell gegen das Ziel prüfen, echte Befunde von Duplikaten und Erfindungen trennen und auch versuchen herauszufinden, was der Agent nie versucht hat. CTF.ae hat XRanges for AI entwickelt, um diesen Kreislauf zu schließen. Die Plattform stellt realistische Zielanwendungen bereit, bei denen jede Dienstkomponente bereits instrumentiert ist, zeichnet auf, was ein Agent tatsächlich darin tut, und bewertet jeden Lauf live anhand von vier unabhängigen Signalen.
Das Überprüfungsproblem wird schlimmer, je mehr Experimente durchgeführt werden. Eine manuelle Prüfung mag für einen einzelnen Lauf machbar sein, aber ein KI-Engineering-Team testet oft drei Modelle, vier Prompt-Varianten und zehn Wiederholungen. Das erzeugt eine Überprüfungswarteschlange, die länger ist als das Experiment selbst. Ein Bericht beschreibt außerdem nur, was der Agent gefunden hat; er schweigt über Funktionen, die der Agent nie geöffnet hat, API-Endpunkte, die er nie aufgezählt hat, und zweite Fehler, die im selben Endpunkt stecken, in dem er den ersten gefunden hat. Es gibt auch den Agenten, der eine Tabelle löscht oder jeden API-Schlüssel widerruft, während er einen Befund erreicht – ein Ergebnis, das kein Kunde akzeptieren würde und das eine Befundliste nicht erfasst. Die manuelle Überprüfung bewältigt diese Matrix nicht.
XRanges for AI ist ein Arbeitsbereich für die gesamte Evaluierung und hat zwei Hälften. Die erste ist eine Bibliothek von Benchmark-Zielen. Jedes Ziel ist eine vollständige Anwendung, nicht eine Sammlung von Puzzle-Herausforderungen: ein Unternehmen mit mehreren Diensten, eigener Geschäftslogik, vorbefüllten Daten, Hintergrundjobs und simuliertem Benutzerverkehr, das über mehrere Sprachen und Frameworks hinweg gebaut wurde, weil echte Software so gebaut wird. Jedes Ziel enthält 20 oder mehr eingebaute Schwachstellen, von einstufigen Fehlern bis hin zu Ketten, die Dienstgrenzen überschreiten, einschließlich Zero-Days, die von CTF.aes eigenen Forschern gefunden wurden. Keines dieser Ziele existiert in öffentlichen Trainingsdaten, was laut Unternehmen jeden Monat wichtiger wird. Die zweite Hälfte ist die Instrumentierungsschicht. Jeder Dienst in jedem Ziel sendet strukturierte Telemetrie über OpenTelemetry, einen Standard, mit dem Software ihre eigene Aktivität meldet. Die Instrumentierung wird von Anwendungssicherheits- und Softwareentwicklern für jedes spezifische Ziel von Hand geschrieben, weil generisches HTTP-Logging das meiste, was zählt, verpassen würde. Die Plattform unter ai.xranges.com konsumiert diese Telemetrie für jede Bereitstellung und verwandelt sie in vier Bewertungen, die sich aktualisieren, während der Agent noch arbeitet.
Die vier Bewertungen sind so gewählt, dass sie unabhängig sind, sodass ein Agent nicht eine verbessern kann, indem er eine andere manipuliert. Abdeckung fragt, ob der Agent das Ziel erkundet hat. Jede benutzerorientierte Funktion ist ein Abdeckungspunkt, der als Geschäftsaktion beschrieben wird, nicht als URL, wie etwa ein Konto registriert, Stellenanzeigen durchsucht, eine geteilte Unterhaltung geöffnet oder Code in einer Prüfung ausgeführt. Ein Abdeckungspunkt kann nur durch normale Nutzung erreicht werden, niemals durch einen Exploit, sodass die Bewertung misst, wie gründlich der Agent die legitime Oberfläche bearbeitet hat. Nicht getroffene Punkte werden namentlich aufgelistet, und die meisten Teams finden diese Liste nützlicher als die Bewertung. Grenzen fragt, ob der Agent die Regeln der Auseinandersetzung respektiert hat. Jedes Ziel wird mit Schutzregeln ausgeliefert, wie „darf keine Einstellungsinhalte löschen“ oder „darf keine API-Schlüssel widerrufen“. Eine Verletzung wird in dem Moment aufgezeichnet, in dem sie passiert, mit Container und Zeitstempel; null Verletzungen sind die Erwartung, und jede Verletzung ist ein Befund über den Agenten, nicht über das Ziel. Ausgenutzt zeichnet auf, welche Schwachstellen der Agent tatsächlich ausgenutzt hat. Jede Schwachstelle ist als Kill-Chain geordneter Phasen definiert, vom ersten Kontakt mit der anfälligen Oberfläche bis zu einem Ausnutzungssignal, das nur bei Erfolg ausgelöst wird. Da jede Phase von innerhalb des Ziels erkannt wird, weiß die Plattform, welchen Schritt der Agent abgeschlossen hat und wo er stecken geblieben ist, unabhängig davon, was der Agent geschrieben hat. Eine dreistufige Zugriffskontrollkette, die bei Schritt zwei stoppte, erscheint genau so: zwei von drei, mit Zeitstempeln. Integrität prüft, ob das Ziel überlebt hat. Prüfungen laufen jede Minute und bestätigen, dass die Anwendung noch funktional korrekt ist, einschließlich vorhandener Seed-Daten, Dienste, die mit dem richtigen Inhalt antworten, und intaktem dienstübergreifendem Vertrauen. Eine fehlgeschlagene Prüfung ist eine Strafe, unabhängig von der Ursache, und erfasst den Agenten, der einen Fehler gefunden hat, indem er die Umgebung um ihn herum kaputt gemacht hat. Die vier Signale summieren sich zu einer Bewertung, aber die Aufschlüsselung zeigt die eigentliche Arbeit.
Ein Lauf beginnt mit einem Ziel, das als isolierte Multi-Container-Umgebung in etwa neunzig Sekunden bereitgestellt wird. Die Plattform kann bis zu tausend Bereitstellungen gleichzeitig ausführen, sodass KI-Ingenieure, Softwareentwickler und das Infrastrukturteam jeweils ihre eigenen Experimente ohne Warteschlange durchführen können. Der Agent läuft dann selbstständig gegen den Bereitstellungsendpunkt; die Plattform steht nie zwischen dem Agenten und dem Ziel, sondern beobachtet von innen. Während der Agent arbeitet, zeichnet eine Zeitleiste auf, was er tatsächlich getan hat, zugeordnet zur Geschäftsfunktionalität, wie etwa eine Stellenanzeige in der Vorschau angesehen, eine Unternehmensanfrage eingereicht oder einen API-Schlüssel erstellt. Ingenieure, die Rohmaterial wollen, können den OpenTelemetry-Stream direkt lesen und mit einer Log-Abfragesprache abfragen, die reguläre Ausdrücke und Attributfilter unterstützt. Wenn der Agent etwas meldet, das nicht im Schwachstellenkatalog des Ziels steht, klärt die Zeitleiste das: Manchmal ist es ein falsch positiver Befund, und manchmal hat der Agent einen echten Fehler gefunden, den niemand eingebaut hat, was mehr als einmal vorgekommen ist.
Für erneutes Testen ist kein zweites Labor erforderlich. Schwachstellen können in einer laufenden Bereitstellung umgeschaltet oder direkt gepatcht werden. Einige Patches werden zur Laufzeit angewendet, andere erfordern einen Neustart von ein oder zwei Minuten. In jedem Fall testet der Agent erneut gegen dieselbe Umgebung mit demselben Zustand. Jede Bereitstellung trägt auch benutzerdefinierte Metadaten wie Modellname, Agentenversion, Prompt-Variante und den Ingenieur, der sie ausgeführt hat. Bereitstellungen werden gruppiert, und eine Gruppe zeigt den Durchschnitt und die beste Bewertung über ihre Läufe sowie eine Ansicht pro Schwachstelle, welcher Lauf welche Kette abgeschlossen hat. Wiederholte Läufe nebeneinander sind der Weg, Varianz von Verbesserung zu trennen; ein einzelner Lauf beweist sehr wenig, und die Plattform basiert auf dieser Annahme. Alles in der Konsole ist auch über eine API und einen Model Context Protocol-Server mit einem Bearer-Token verfügbar. Das Bereitstellen einer Reihe von Zielen, das Starten des Agenten, das Abrufen von Abdeckung und Kill-Chain-Fortschritt und das Sammeln des Vergleichs am Ende können aus einer CI-Pipeline oder von einem Chat-Assistenten ohne Aufsicht ausgeführt werden. Die Konsole ist für Menschen, die Ergebnisse lesen; die API ist für die Experimentmatrix.
Feldbeweis kam auf der DEF CON 34 im August 2026. Die Bug Bounty Village veranstaltet jedes Jahr auf der DEF CON einen Capture-the-Flag-Wettbewerb für die Bug-Hunting-Community, und für diese Ausgabe baute CTF.ae das Ziel: Xenoptic, ein fiktives KI-Unternehmen mit einem anspruchsvollen Umfang. Jeder der 545 registrierten Spieler erhielt eine eigene isolierte Kopie des gesamten Unternehmens, und XRanges for AI beobachtete jeden einzelnen von ihnen die vollen 48 Stunden lang. Der Grund war Fairness. Ein Wettbewerb wie dieser wird normalerweise anhand eingereichter Berichte bewertet, aber ein Bericht allein sagt nichts darüber aus, wie der Spieler dorthin gelangt ist. Jemand könnte einen unbeabsichtigten Fehler treffen, der alle Flags auf einmal offenlegt, eine externe CVE einbringen, den Container verlassen und Flags sammeln, ohne die Anwendung zu berühren. CTF.ae musste sehen, wie jeder Spieler und der Agent jedes Spielers sich tatsächlich durch die Umgebung bewegten, damit eingereichte Berichte gegen das abgeglichen werden konnten, was in der Bereitstellung dieses Spielers wirklich passiert war. Über mehr als 850 Bereitstellungen hinweg streamte die Plattform dieselben vier Signale, die sie jetzt bei Agenten verwendet: Integrität bestätigte, dass jede Umgebung gesund blieb, Grenzen zeichneten auf, wer die Regeln der Auseinandersetzung überschritt, Abdeckung zeigte, wie viel des Ziels jeder Spieler tatsächlich durchgearbeitet hatte, und Ausgenutzt zeichnete auf, welche Schwachstellen wirklich ausgenutzt wurden und in welchem Schritt, sodass jede Einreichung gegen einen echten Pfad geprüft werden konnte. All das kam von innerhalb des Ziels, niemals vom Rechner des Spielers. Hunderte gleichzeitige Bereitstellungen unter anhaltendem Angriff durch erfahrene Forscher sind ein härterer Test als ein Agent in einem Labor, und dieselbe Instrumentierung bewertet jetzt Agenten.
CTF.ae sagt, XRanges for AI sei für Teams, die autonome Sicherheitsagenten entwickeln und wissen müssen, was ihr Agent getan hat, statt was er behauptet hat. Es läuft als verwalteter Cloud-Dienst oder selbst gehostet auf der Infrastruktur des Kunden, wo nichts seine Umgebung verlässt. Teams, die einen Agenten auf ein Ziel ansetzen wollen, das er noch nie gesehen hat, können CTF.ae kontaktieren. Für Organisationen, die auf automatisierte Sicherheitswerkzeuge angewiesen sind, ist die Notwendigkeit zu überprüfen, was ein Werkzeug tatsächlich getan hat, statt was es behauptet hat, eine praktische Erinnerung. AEU-I bietet sicherheitsorientierte IT, Infrastruktur und Beratung, die Teams dabei unterstützen kann, solche Werkzeuge und die von ihnen erzeugten Nachweise zu prüfen, bevor sie Produktivsysteme berühren.
So schützen Sie sich
- Wenn Sie ein automatisiertes Sicherheitsprodukt in Betracht ziehen, bitten Sie den Anbieter um Testergebnisse, die zeigen, was das Werkzeug auf einer separaten Testseite tatsächlich getan hat, nicht nur, was es gemeldet hat.
- Bevor Sie ein Sicherheitswerkzeug Ihre Website scannen oder ändern lassen, erstellen Sie eine vollständige Sicherung und testen Sie, ob Sie sie wiederherstellen können.
- Führen Sie ein neues Sicherheitswerkzeug zuerst auf einer Staging-Kopie Ihrer Website aus und geben Sie ihm die Erlaubnis zu schauen, aber nichts zu ändern, bis Sie ihm vertrauen.
- Prüfen Sie anschließend die vom Werkzeug bereitgestellten Aktivitätsaufzeichnungen oder Protokolle, um genau zu sehen, worauf es zugegriffen oder was es geändert hat.
- Halten Sie Ihre Website und jedes Sicherheitswerkzeug auf dem neuesten Stand, denn veraltete Komponenten können ebenfalls irreführende Ergebnisse liefern.
Begriffe Erklärt
- OpenTelemetry Ein Standard, mit dem Software Aufzeichnungen darüber, was sie tut, an ein Überwachungssystem sendet.
- Telemetry Informationen, die ein Computersystem automatisch über seine eigene Aktivität sendet, wie ein detailliertes Aktivitätsprotokoll.
- Vulnerability Eine Schwachstelle in Software, die ein Angreifer nutzen kann, um einzudringen oder Schaden zu verursachen.
- Zero-day Ein Softwarefehler, der dem Anbieter unbekannt ist und für den es noch keine offizielle Lösung gibt, sodass Angreifer ihn nutzen können, bevor jemand vorbereitet ist.
- Kill chain Eine Schritt-für-Schritt-Abfolge, die ein Angreifer abschließen muss, um eine Schwachstelle erfolgreich auszunutzen.
- Autonomous security agent Ein Computerprogramm, das selbstständig nach Sicherheitsproblemen suchen und Entscheidungen treffen kann, ohne dass ein Mensch jeden Schritt anleitet.